Thesis/Dissertation: Bc. Jan Bušta, učo 172959: Automatic retrieval of varbal idioms from corpora
Master's thesis
Automatic retrieval of varbal idioms from corpora
Automatická extrakce slovesných idiomů z korpusu
Abstract
Práce se zabývá porovnáním algoritmů pro automatickou extrakci idiomatických frází z korpusu, zkoumá různé přístupy pro řešení problému a do českého jazykového prostředí implementuje algoritmus A. Fazlyho a S. Stevensonové, který se zakládá na lexikální a syntaktické pevnosti vazeb v idiomech, které jsou tvořeny tranzitivním slovesem a jeho přímým předmětem.
Abstract
This thesis describes comparison of algorithms for automatic extraction of idiomatic phrases from corpora, compare different approaches and implementing the algorithm of A. Fazly and S. Stevenson into Czech language environment. This algorithm is based on lexical and syntactical fixedness of binding in idioms, which are composed from transitive verb its direct object.
Thesis description
Student nastuduje současné algoritmy používané pro automatické vyhledávání slovesných idiomatických frází v textových korpusech, provede jejich porovnání a následně implementuje vhodný z nich. Kromě implementace bude součástí práce i databáze extrahovaných idiomatických spojení z vybraných českých korpusů (např. SYN2000, czes), vyhodnocení správnosti pro část takto získaných dat a jejich porovnání se SČFI.
Práce je součástí projektů spojených s činností Laboratoře zpracování přirozeného jazyka a jako taková bude vyžadovat pravidelné zveřejňování dosažených výsledků ve formě souhrnné zprávy vždy na konci každého kalendářního měsíce po celou dobu řešení. Tyto zprávy budou vystaveny na webových stránkách Laboratoře. Řešiteli bude zřízen účet na hlavním serveru, případně i na pracovních stanicích Laboratoře.
Práce je vypisována v rámci projektu OP VK s názvem Platforma výzkumné a vzdělávací spolupráce FI MU v oblasti zpracování dat, reg. číslo CZ.1.07/2.4.00/12.0049, a aktivit SPP.10/1/2012 13:28, RNDr. Miloš Jakubíček, Ph.D., UČO 172962
- Entered/Edited 7/2/2012 13:45, Eva Drštková
- Record made 21/11/2011 14:11, Helena Kryštofová
- Accessible from: 9/1/2012 11:34, Helena Kryštofová
- Thesis/dissertation received 9/1/2012 11:34, Helena Kryštofová
 Czech
Supervisor
Literature
- ČERMÁK, František. Slovník české frazeologie a idiomatiky. 2. přeprac. a dopl. vyd., 1. Praha: Leda, 2009, 507 s. ISBN 9788073352158.
- FAZLY, A and S STEVENSON. Automatically constructing a lexicon of verb phrase idiomatic combinations. In Proceedings of the 11th Conference of the European Chapter of the Association for Computational Linguistics (EACL-2006). 2006, 344 pp.
- BANNARD, Colin. A measure of syntactic flexibility for automatically identifying multiword expressions in corpora. In Proceedings of the Workshop on a Broader Perspective on Multiword Expressions. Association for Computational Linguistics, 2007, 8 pp.
Theses on a related topic
List of theses with an identical keyword.
-
The changes in the 1st person singular and 3rd person plural forms of the verb types: krýt, kupovat, mazat
Mgr. Štěpánka Mendlová -
Browser plug-in for Czech language corrector
Mgr. Bc. Matouš Ejem, UČO 393725 -
Prefixed nouns in Russian and Czech: a corpus study of prefix bez-
Bc. Iva Táborská -
Online Proofreader as a Result of Czech Language Rule Formalization
Mgr. Vojtěch Mrkývka, Ph.D., UČO 421310 -
Bilingualism and Interference: A Corpus-based Linguistic Analysis of Bilingual Children’s Speech in a Czech-English Environment
Bc. Lucie Olijnyková -
Web interface for a Czech automatic language corrector
Mgr. Vojtěch Mrkývka, Ph.D., UČO 421310 -
Computing Frequency of Headwords in Text Corpus
Mgr. Jan Bušta, UČO 172959 -
Phraseological Complement of Verbs in Valency Database VerbaLex
Michaela Trněná
Folders
Files
-
Přidání souboru
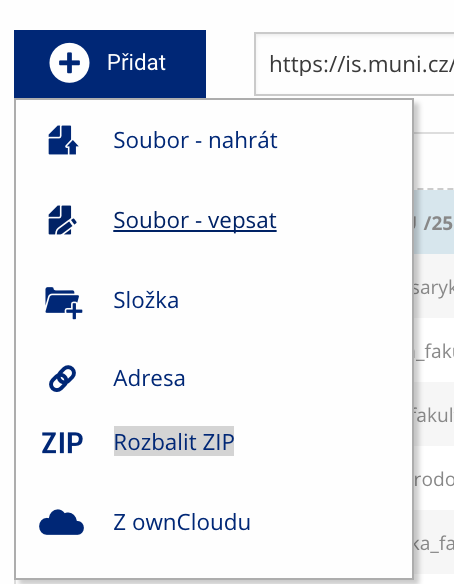 Soubor nebo složku lze nahrát pomocí tlačítka Přidat.
-
Další operace se soubory
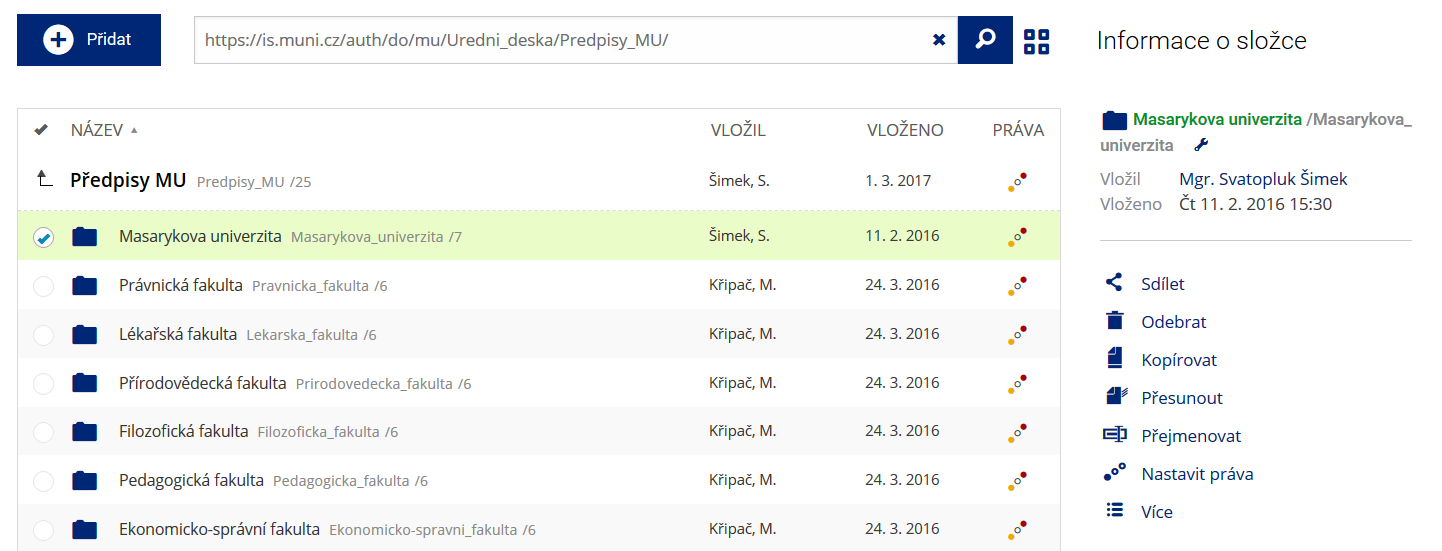 Podrobnosti lze zjistit označením příslušného řádku.
-
Pohled pro experty
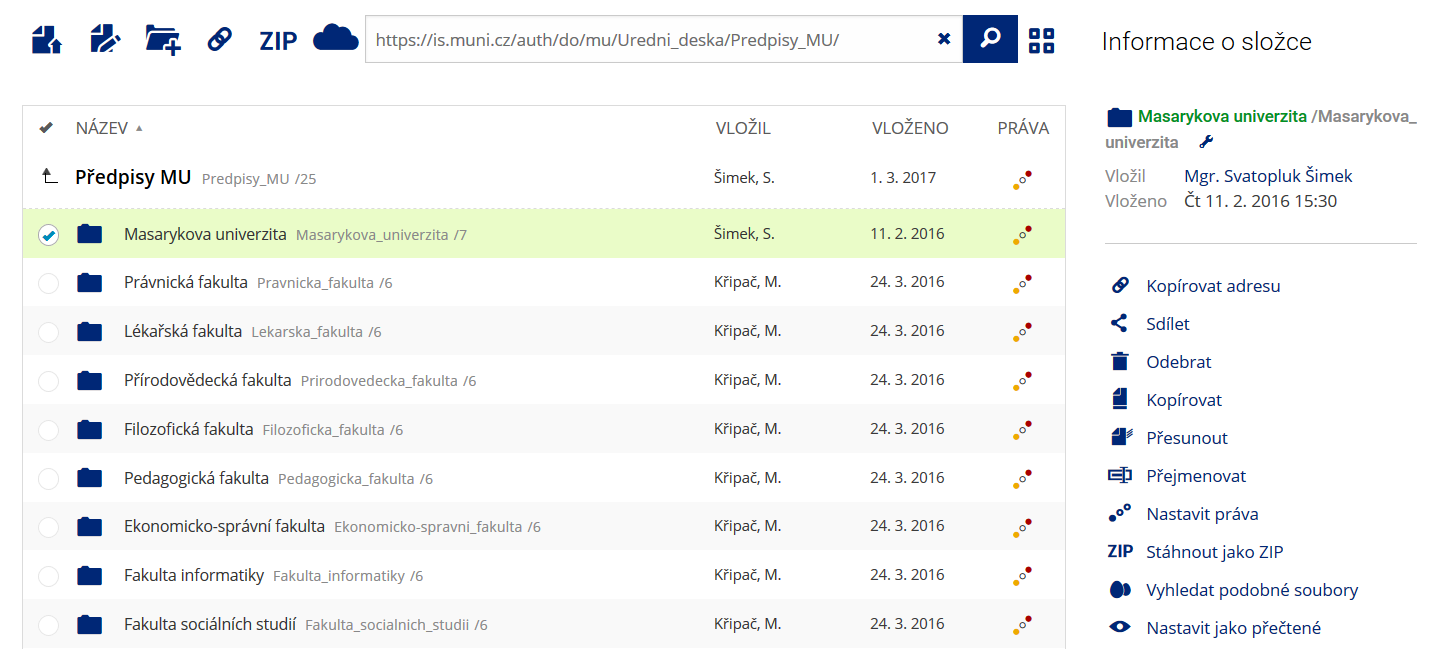 Pro častou práci je možné zvolit režim Více možností.
-
Vyhledávání souborů
 Vyhledávaný výraz můžete zadat přímo do adresního řádku.
-
Rychlý přístup k souborům
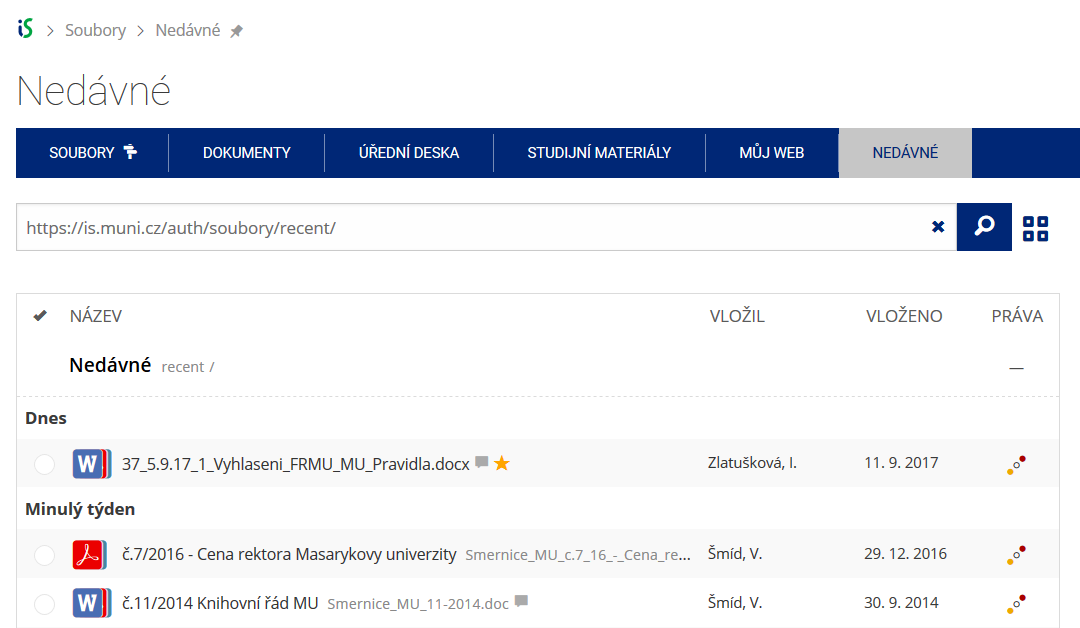 Pomocí funkce Nedávné je možné se rychle vrátit k právě prohlíženým souborům. Oblíbené soubory je také možné označit Hvězdičkou.