Závěrečná práce: Tomáš Houfek: Data extraction from medical records
Bakalářská práce
Data extraction from medical records
Anotace
Tato práce se zabývá extrakcí užitečných informací z lékařských zpráv. Cílem práce je schopnost automaticky vyplňovat hlášenku novotvaru pro Národní onkologický registr. Pro implementaci tohoto úkolu jsou použity dva způsoby extrakce informací. Pravidlový přístup, extrakce s pomocí regulárních výrazů a přístup hlubokého učení, konkrétně model rozpoznávání jmenných entit (Named Entity Recognition) založený …více
Abstract
This thesis focuses on automatically extracting valuable information from medical records. The specific goal of this thesis is to fill the Neoplasm incidence report from the National Oncology Registry automatically. To achieve this, two extraction approaches are used. Rule-based Regular Expression extraction and Deep-learning Medical Named Entity Recognition model based on the Transformer architecture …více
Zadání práce
24. 5. 2022 21:28, Mgr. Zdenka Dudová, Ph.D., učo 211728
 angličtina
Práce na příbuzné téma
Seznam prací, které mají shodná klíčová slova.
-
Mining Czech Clinical Notes Using the Language Modelling Technology
Mgr. Tomáš Houfek -
Automatic text summarization
Mgr. Adam Hájek -
Classification and Named Entity Recognition in Airline Emails
Mgr. Bruno Húževka -
Deriving the Meaning of Out-of-Vocabulary Words
Mgr. Samuel Gazda -
Pretraining and Evaluation of Czech ALBERT Language Model
RNDr. Petr Zelina, učo 469366 -
Anonymisation of Clinical Notes
Bc. Karolína Rusnačková, učo 525276 -
Domain-specific English-Czech Neural Machine Translation
Mgr. Martin Wörgötter -
Identifikace polohových informací v nestrukturovaném textu
Mgr. Marie Valíčková
Složky
Soubory
-
Přidání souboru
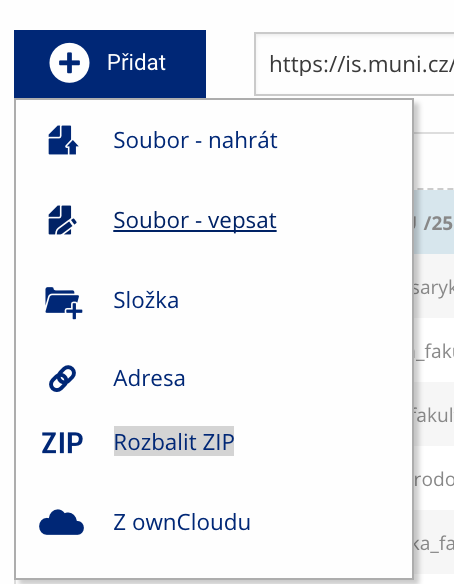 Soubor nebo složku lze nahrát pomocí tlačítka Přidat.
-
Další operace se soubory
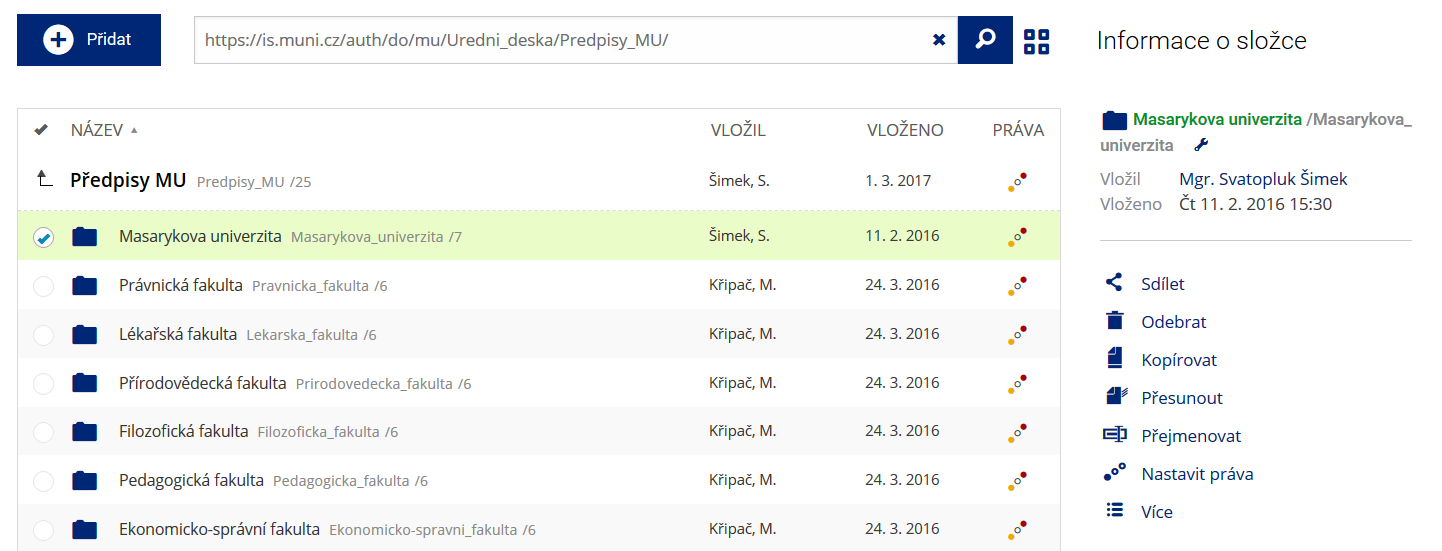 Podrobnosti lze zjistit označením příslušného řádku.
-
Pohled pro experty
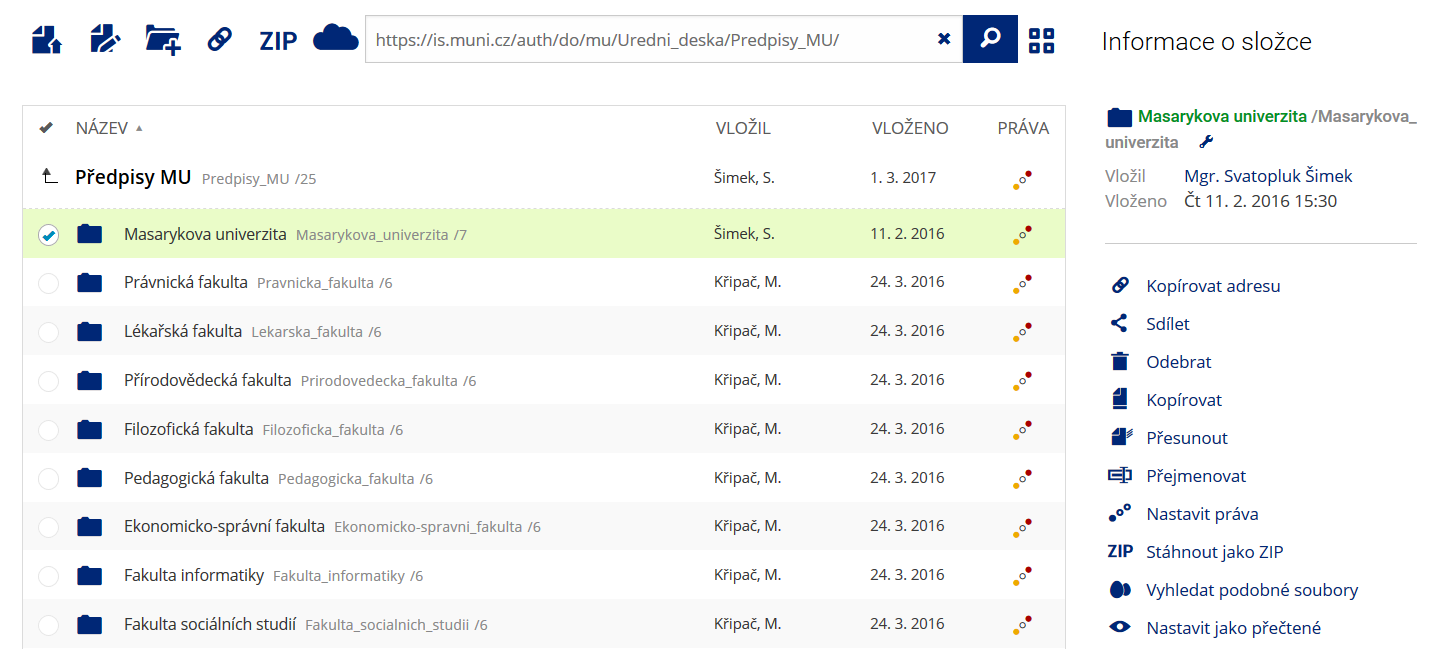 Pro častou práci je možné zvolit režim Více možností.
-
Vyhledávání souborů
 Vyhledávaný výraz můžete zadat přímo do adresního řádku.
-
Rychlý přístup k souborům
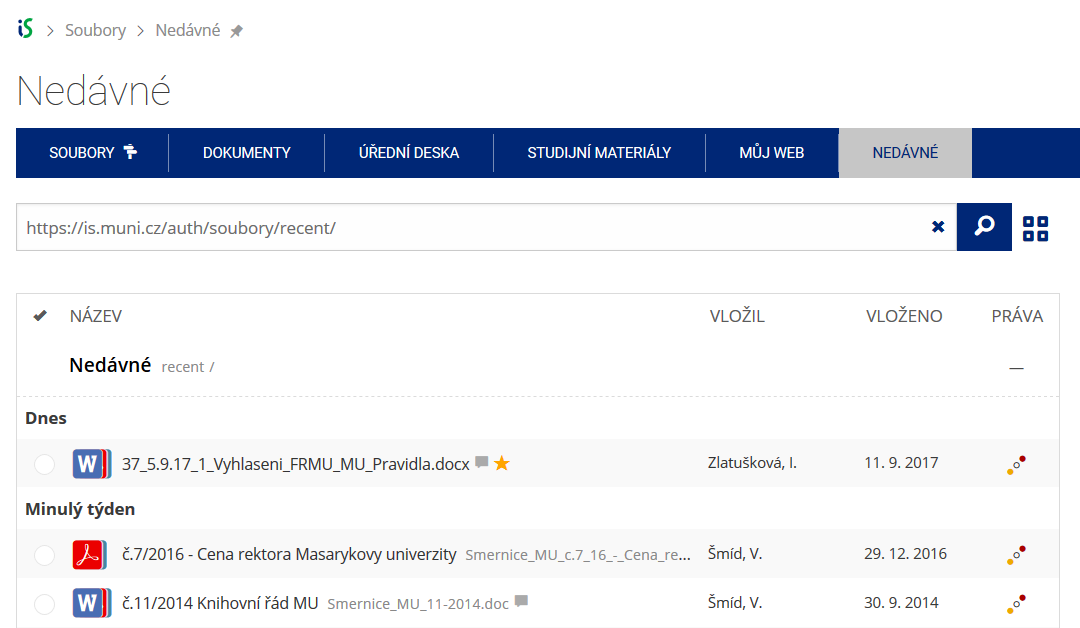 Pomocí funkce Nedávné je možné se rychle vrátit k právě prohlíženým souborům. Oblíbené soubory je také možné označit Hvězdičkou.